AI i 2025: Det, der faktisk ændrede sig

Et kritisk, dateret tilbageblik på AI i 2025: ræsonnerende modeller, AI-agenter, generativ video, DeepSeek og AI Act. Hvad ændrede arbejdsformen, og hvad skulle teams stadig kontrollere?
2025 blev året, hvor AI i højere grad flyttede fra det enkelte svar til en længere arbejdsproces. Modeller brugte mere beregning på svære opgaver, agentprodukter fik adgang til værktøjer, og generativ video begyndte at kombinere levende billeder med lyd. Samtidig blev kontrol ikke mindre vigtig. Tværtimod blev kildekritik, adgangsstyring og menneskelig godkendelse mere centrale, når systemerne kunne gøre mere.
Det er den praktiske ændring, der binder AI-året 2025 sammen. Ikke at én bestemt model vandt, eller at arbejdet pludselig kunne overlades til en digital medarbejder. Men at flere dele af en opgave kunne samles i samme forløb. Det gav nye muligheder og flere steder, hvor en fejl kunne få betydning.
Fra hurtige svar til mere arbejde med svære opgaver
En tydelig produktretning i 2025 var modeller, der kunne bruge mere tid og beregning på komplekse spørgsmål. Google lancerede den eksperimentelle Gemini 2.5 Pro den 25. marts og beskrev den som en “thinking model”. Den 22. maj præsenterede Anthropic Claude Opus 4 og Sonnet 4 med såkaldt extended thinking og mulighed for at bruge værktøjer undervejs. Det er leverandørernes egne beskrivelser og resultater, ikke et bevis på, at modellerne var bedst til enhver opgave.
OpenAI gik en lidt anden vej med GPT-4.1, som blev lanceret i API’et den 14. april. Her fremhævede virksomheden især bedre kodning, instruktionsefterlevelse og håndtering af lang kontekst. Tilsammen viste lanceringerne en forskydning: Det afgørende spørgsmål var ikke længere kun, hvor flydende en model kunne formulere et svar, men om den kunne fastholde instruktioner, arbejde med meget materiale og løse en sammensat opgave trin for trin.
Det gjorde modelvalg mere konkret. En imponerende demonstration eller en høj benchmarkscore kunne stadig være relevant, men sagde ikke nødvendigvis noget om virksomhedens egen opgave. Den nyttige test var i stedet afgrænset: Kan modellen finde de rigtige oplysninger i fem konkrete dokumenter? Kan den følge en bestemt skabelon? Kan en fagperson kontrollere resultatet uden at gentage hele arbejdet? AIBI’s oversigt over AI-værktøjer uddyber, hvorfor valget bør begynde med opgaven frem for modelnavnet.
Mere “tænkning” fjernede heller ikke hallucinationer eller behovet for kontrol. En længere ræsonneringsproces kan stadig bygge på en forkert antagelse. I praksis blev det derfor mere værdifuldt at definere acceptkriterier, give relevante kilder og kontrollere det færdige resultat end blot at bede om et bedre svar.
Agenter blev et produktspor, ikke en medarbejder på autopilot
Agentbegrebet rykkede i 2025 fra udviklerdiskussioner ind i synlige produkter. OpenAI lancerede Operator som en amerikansk research preview den 23. januar. Systemet kunne bruge en browser og interagere med hjemmesider. Den 17. juli samlede virksomheden dele af Operator og deep research i ChatGPT agent, som kunne skifte mellem browser, terminal og andre værktøjer i flertrinsopgaver.
Det væsentlige var ikke ordet “agent”, men kombinationen af model, værktøjer og adgang. En almindelig chatbot returnerer typisk tekst. Et agentforløb kan få lov til at søge, læse filer, køre kode eller udfylde felter. Det giver praktisk værdi, men ændrer også risikobilledet. En forkert tekst kan rettes. En forkert handling kan påvirke data, kunder eller systemer.
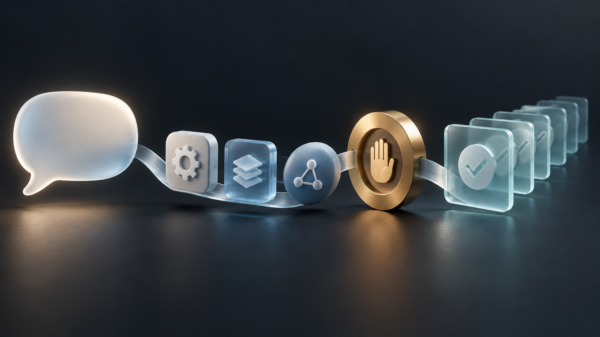
Derfor bør en AI-agent ikke behandles som en medarbejder, der frit kan arbejde videre. Den bør behandles som et system med en nøje afgrænset rolle. Hvilke datakilder må den læse? Hvilke handlinger må den foreslå? Hvilke handlinger kræver godkendelse? Og hvordan kan man bagefter se, hvad der skete?
Kilderne omkring agenten er lige så vigtige som dens værktøjer. Hvis den skal besvare spørgsmål ud fra interne dokumenter, kan en kontrolleret søge- og kildeproces være mere nyttig end at lægge alt ind i en lang prompt. Det er grundideen i RAG, hvor AI bruger dokumenter og kilder. Men kildehenvisninger skal stadig åbnes og kontrolleres. Et link i et svar er ikke i sig selv dokumentation for, at påstanden er dækket.
Generativ video fik lyd og krævede mere kildekritik
Den 20. maj præsenterede Google Veo 3, som ifølge virksomheden kunne generere video med blandt andet dialog, lydeffekter og baggrundslyd. Lanceringen var ikke bare endnu et trin i billedkvalitet. Når lyd, stemmer og levende billeder kan skabes samlet, bliver det lettere at fremstille en scene, der virker som et færdigt klip frem for en teknisk prøve.
Det ændrede arbejdsprocessen for kreative teams. En idé kunne hurtigere blive til et storyboard, en stemningsprøve eller et foreløbigt videoudkast. Men et overbevisende klip siger ikke noget om, hvorvidt begivenheden har fundet sted. Jo mere poleret materialet bliver, desto vigtigere bliver oprindelse, rettigheder og tydelig mærkning.
Det gælder også uden for videoproduktion. Multimodale modeller arbejder på tværs af tekst, billeder, lyd og video, og output kan derfor blande flere udtryk i samme svar. Et team bør kunne svare på, hvilke kilder der ligger bag, om det anvendte materiale må bruges, og hvordan modtageren kan skelne dokumentation fra syntetisk illustration. Googles lancering viste en teknisk retning i 2025, men den dokumenterede ikke, at alle funktioner var tilgængelige i Danmark.
DeepSeek offentliggjorde DeepSeek-R1 den 20. januar sammen med modelvægte og en teknisk rapport om træningen. Udgivelsen gav udviklere flere muligheder for at undersøge, tilpasse og køre ræsonnerende modeller uden at være bundet til én lukket tjeneste. Men betegnelser som “åben” eller “open source” kan skjule vigtige forskelle mellem kode, modelvægte, træningsdata og licensvilkår. Derfor er det mere præcist at undersøge de enkelte dele end at sætte én etiket på hele løsningen.
Den bredere lære fra 2025 var, at valg af model og valg af leverandør ikke er det samme spørgsmål. En model kan bruges gennem en leverandørs egen tjeneste, hentes som vægte eller tilbydes af en tredjepart. Hver løsning kan have forskellige vilkår for databehandling, logning, support, opdateringer og geografisk placering.
Det betyder ikke, at én oprindelse automatisk gør et produkt sikkert eller usikkert. Det betyder, at indkøb og implementering bør omfatte mere end en funktionsliste. Hvilke data forlader organisationen? Hvem driver den konkrete tjeneste? Kan versionen låses? Hvordan opdages ændringer? Og hvem har ansvaret, når modellen indgår i en forretningsproces? DeepSeek gjorde disse spørgsmål sværere at ignorere, men svaret afhænger af den konkrete implementering.
EU’s AI Act blev en praktisk agenda
2025 gjorde også EU’s AI Act mere konkret. Artikel 4 om AI-færdigheder begyndte at finde anvendelse den 2. februar 2025. På det tidspunkt krævede bestemmelsen, at udbydere og anvendere af AI-systemer tog skridt til at sikre et tilstrækkeligt niveau af AI-færdigheder hos relevante medarbejdere og andre personer, der brugte systemerne på deres vegne.
Den juridiske ordlyd har siden ændret sig. EU-Kommissionens aktuelle spørgsmål og svar oplyser, at en ændring fra juli 2026 fjernede kravet om et bestemt eller “tilstrækkeligt” niveau, mens pligten til at understøtte AI-færdigheder blev bevaret. Det er derfor vigtigt at skelne mellem, hvad der skete i 2025, og den retstilstand en virksomhed skal forholde sig til nu.
En anden milepæl kom den 2. august 2025, hvor forpligtelser for udbydere af generelle AI-modeller, ofte kaldet GPAI-modeller, begyndte at finde anvendelse. EU-Kommissionen fremhæver blandt andet teknisk dokumentation, information til downstream-udbydere, en politik for overholdelse af EU’s ophavsret og et resumé af det indhold, der er brugt til træning. Modeller med systemisk risiko er omfattet af yderligere krav.
De to spor må ikke blandes sammen. AI-færdigheder vedrører udbydere og anvendere af AI-systemer og de mennesker, der arbejder med dem. GPAI-forpligtelserne retter sig mod udbydere af de generelle modeller. For en dansk virksomhed var den praktiske pointe i 2025 derfor ikke, at alle skulle blive juridiske specialister, men at ansvar, kompetencer og dokumentation skulle ind i den almindelige styring. AIBI’s praktiske introduktion til EU’s AI Act giver den bredere sammenhæng. Dette afsnit er generel information, ikke juridisk rådgivning.
Hvad ændringerne betød for danske teams
I tilbageblikket på AI-året 2023 var generativ AI’s gennembrud og de nye muligheder i centrum. I 2025 var spørgsmålet i højere grad, hvordan kapaciteten kunne indgå i en stabil arbejdsproces. Fire enkle principper går igen på tværs af modeller, agenter, medier og regulering:
- Test en rigtig, afgrænset opgave. Brug egne acceptkriterier og materiale, som en fagperson kan vurdere. En leverandørbenchmark er ikke en erstatning for en arbejdsgangstest.
- Begræns data og tilladelser. Giv kun adgang til det, opgaven kræver. Begynd med læseadgang og forslag, før et system får lov til at foretage ændringer.
- Bevar menneskelig godkendelse ved konsekvensfulde handlinger. Betalinger, offentliggørelse, kundekommunikation og ændringer i centrale systemer bør have et tydeligt kontrolpunkt.
- Dokumentér nok til at kunne undersøge fejl. Registrér model eller tjeneste, relevante instruktioner, datakilder, værktøjer og godkendelser. Dokumentationen skal gøre det muligt at forstå et resultat, ikke blot vise, at AI blev brugt.
Det mest holdbare resultat af 2025 var dermed ikke et bestemt modelnavn. Det var et skifte i arbejdsformen: AI kunne håndtere flere led, men værdien afhang stadig af afgrænsning, gode kilder og mennesker, der havde mandat til at stoppe eller rette processen. Jo mere et system kunne gøre, desto vigtigere blev det at beslutte, hvad det ikke måtte gøre alene.