En sprogmodel kan formulere et flydende svar uden først at slå noget op i virksomhedens aktuelle dokumenter. Det er et problem, hvis spørgsmålet handler om en personalehåndbog, en produktmanual eller andet materiale, som modellen ikke nødvendigvis kender.
Retrieval-Augmented Generation, forkortet RAG, er en måde at koble søgning i en afgrænset samling af materiale sammen med en sprogmodel. Systemet finder først relevante tekststykker og giver dem derefter til modellen som kontekst for svaret. Det kan gøre et svar mere relevant og lettere at kontrollere, men RAG er ikke en sandhedsmaskine.
Hvad betyder RAG?
RAG står for Retrieval-Augmented Generation. På almindeligt dansk kan det beskrives som tekstgenerering suppleret med hentet kildemateriale.
Retrieval er den del, der finder materiale. Generation er den del, hvor en stor sprogmodel (LLM) formulerer et svar. Metoden blev beskrevet i forskningsartiklen af Lewis et al. fra 2020 som en kombination af modellens indlærte viden og en ekstern, søgbar hukommelse.[1]
RAG er dermed ikke en ny type model ved siden af generativ AI. Det er et systemmønster, der kan give generativ AI udvalgt materiale at arbejde med.
Sådan fungerer RAG i praksis
Forestil dig en virksomhed, der vil lade medarbejderne stille spørgsmål til en intern personalehåndbog. Et enkelt spørgsmål kunne være: “Hvor mange omsorgsdage har jeg ret til?”
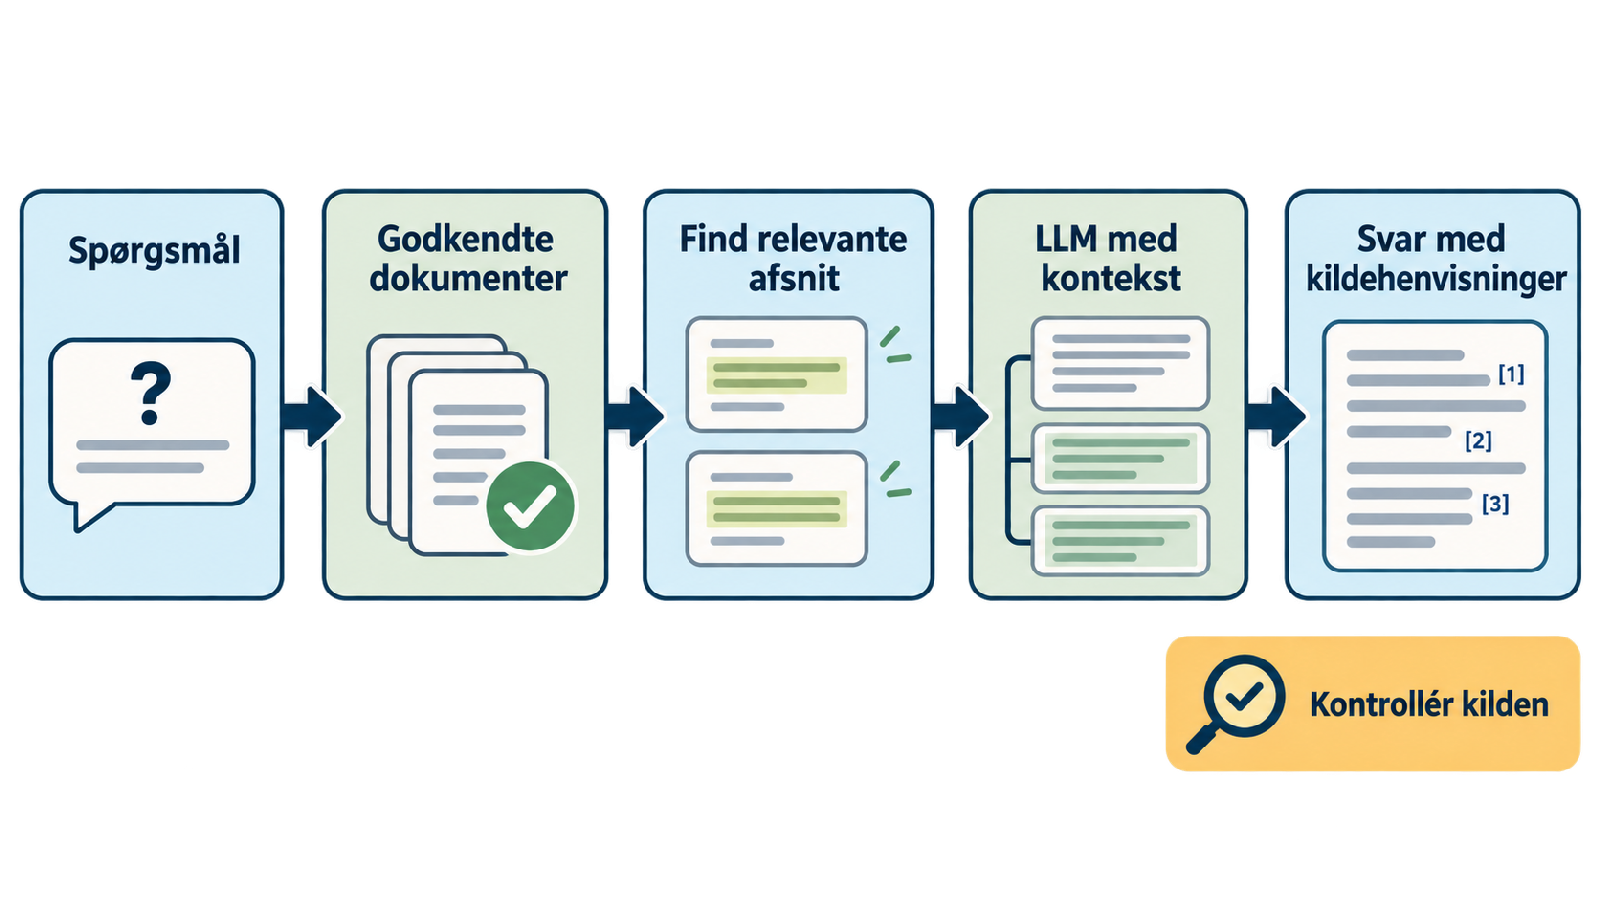
1. Dokumenterne gøres søgbare
Før systemet kan finde noget, skal det relevante materiale forberedes. Lange dokumenter deles ofte i mindre tekststykker, også kaldet chunks. Det gør det muligt at hente et bestemt afsnit om omsorgsdage i stedet for at sende hele håndbogen til modellen.
Tekststykkerne kan gemmes i et søgeindeks. Nogle løsninger bruger embeddings, som er talbaserede repræsentationer af tekstens betydning. De kan bruges til vektorsøgning, hvor systemet leder efter tekst med en betydning, der ligner spørgsmålet. Andre løsninger bruger nøgleordssøgning eller en kombination. RAG er altså ikke bundet til én bestemt søgemetode.[2]
2. Systemet finder relevante afsnit
Når medarbejderen stiller sit spørgsmål, søger systemet i det materiale, det har adgang til. Målet er at finde få, relevante tekststykker. I eksemplet kan det være afsnittet om omsorgsdage og ikke de nærliggende afsnit om ferie eller sygdom.
Dette led er afgørende. Hvis søgningen overser det rigtige afsnit eller vælger et gammelt dokument, får modellen et dårligt grundlag for sit svar.
3. Spørgsmål og tekststykker sendes til modellen
De valgte tekststykker føjes til spørgsmålet som kontekst. Modellen bliver typisk bedt om at besvare spørgsmålet ud fra dette materiale. En tydelig instruktion kan hjælpe modellen med at holde sig til opgaven, men gode prompts kan ikke i sig selv sikre, at søgningen har fundet den rigtige kilde.
4. Modellen formulerer svaret
Modellen genererer et svar på baggrund af spørgsmålet og den hentede kontekst. Hvis løsningen er bygget til det, kan svaret også vise kildehenvisninger, så medarbejderen kan åbne det relevante afsnit i håndbogen.
Hvad kan RAG forbedre?
RAG kan især være nyttigt, når svar skal bygge på en bestemt dokumentsamling frem for alene på det, sprogmodellen lærte under sin træning.
- Mere relevant kontekst: Systemet kan hente materiale fra et afgrænset område, for eksempel virksomhedens egne retningslinjer.
- Lettere opdatering: Dokumenter kan opdateres i samlingen uden nødvendigvis at træne selve sprogmodellen igen.
- En vej tilbage til kilden: Et system kan vise, hvilke dokumenter eller afsnit der blev brugt, så læseren har noget konkret at kontrollere.
Fordelene opstår dog ikke automatisk. De afhænger blandt andet af dokumenternes kvalitet, opdelingen i tekststykker, søgemetoden, instruktionerne til modellen og den løbende evaluering. Microsofts aktuelle arkitekturbeskrivelse fremhæver netop relevant og præcis hentning som en central udfordring i RAG-systemer.[2]
Hvad løser RAG ikke?
RAG fjerner ikke muligheden for fejl. Problemet kan opstå både før og efter, at materialet når frem til modellen.
Dokumentsamlingen kan være mangelfuld, forældet eller fyldt med næsten ens versioner. Søgningen kan vælge et afsnit, der bruger de rigtige ord, men ikke besvarer spørgsmålet. Og selv med et relevant tekststykke kan modellen misforstå det, blande oplysninger sammen eller tilføje en slutning, som kilden ikke understøtter.
En kildehenvisning er derfor ikke i sig selv bevis for, at svaret er korrekt. Den kan pege på et relevant dokument uden at understøtte den konkrete påstand. Forskning i evaluering af RAG skelner tilsvarende mellem kvaliteten af de hentede tekststykker, modellens trofasthed mod dem og kvaliteten af det genererede svar.[3]
Adgang til dokumenter kræver også omtanke. Systemet bør kun kunne hente materiale, som brugeren må se. Det er en generel driftsmæssig kontrol, ikke en garanti for, at en bestemt løsning håndterer fortrolige oplysninger korrekt. Ved beslutninger med store konsekvenser bør en ansvarlig person kontrollere både kilde og svar.
RAG er ikke det samme som en LLM, søgning eller en AI-agent
| Begreb | Hovedopgave |
|---|---|
| LLM | Genererer tekst ud fra det input og den kontekst, modellen får. |
| Søgesystem | Finder dokumenter eller tekststykker, der vurderes som relevante. |
| RAG | Kobler hentning af materiale sammen med et genereret svar. |
| AI-agent | Arbejder mod et mål med valgte værktøjer og handlinger og kan bruge RAG som kilde til kontekst. |
RAG handler om at hente og tilføre kontekst, ikke om selvstændigt at udføre handlinger. En AI-agent kan bruge RAG, men agentens mål, værktøjer, tilladelser og kontrolmekanismer er et andet emne.
RAG er heller ikke bare navnet på en chatbotfunktion. En chatbot som ChatGPT er et produkt og en brugerflade, mens RAG beskriver et generelt arkitekturmønster. Om et bestemt produkt henter kilder, og hvordan det gør det, afhænger af produktets aktuelle funktioner og opsætning.
Fem kontroller før du stoler på et RAG-svar
- Åbn kilden. Kontrollér, at henvisningen fører til det dokument og afsnit, som svaret bygger på.
- Sammenlign påstanden med teksten. Se efter, om kilden faktisk siger det samme, eller om svaret går længere end belægget.
- Tjek dato og ejer. Et korrekt gengivet afsnit kan stadig være forældet eller komme fra et dokument uden tydelig ansvarlig.
- Prøv et kendt spørgsmål. Brug et spørgsmål, hvor det korrekte svar allerede er fastlagt, og undersøg både svar og hentede kilder.
- Vurdér adgang og datahåndtering. Bekræft, at brugeren må se materialet, og at løsningen passer til organisationens krav, før følsomme dokumenter indgår.
Hvis du senere skal vælge et AI-værktøj, er det derfor mere oplysende at undersøge kildevisning, dokumentstyring og muligheder for evaluering end blot at lede efter ordet RAG i en funktionsliste.
Ofte stillede spørgsmål om RAG
Hvad står RAG for?
RAG står for Retrieval-Augmented Generation. Det kan forklares som tekstgenerering, der suppleres med materiale hentet fra en ekstern kilde.
Er RAG det samme som en LLM?
Nej. En LLM genererer tekst. RAG tilføjer et trin, hvor et system finder relevant materiale og giver det til modellen som kontekst.
Fjerner RAG hallucinationer?
Nej. Relevant kildemateriale kan mindske nogle svar uden belæg, men både søgningen og modellens brug af materialet kan fejle.
Beviser en kildehenvisning, at svaret er korrekt?
Nej. Du skal åbne kilden og kontrollere, at den understøtter den konkrete påstand, og at dokumentet stadig er aktuelt.
Er RAG det samme som en AI-agent?
Nej. En agent kan bruge RAG til at hente kontekst, men en agent omfatter også mål, mulige handlinger, værktøjer og kontrol.
RAG kan gøre en sprogmodel mere nyttig med en klart afgrænset samling af materiale. Kvaliteten afhænger stadig af dokumenterne, søgningen, modellens brug af konteksten og den kontrol, der sker bagefter.