Tjek en AI-skrevet unit test: Fanger den også grænsefejlen?
En grøn test kan overse en fejl. Se, hvordan du kontrollerer en AI-skrevet Python-test mod kravet og et bevidst forkert grænseresultat.
En grøn test kan give falsk ro, hvis den aldrig prøver det input, hvor kravet skifter. Har du fået foreslået en Python-test af en AI-assistent, så læs dens forventede svar, før du lægger vægt på det grønne resultat. Her er et lille, konstrueret eksempel. Testen er ikke et faktisk svar fra Copilot eller en anden AI-tjeneste.
AI-genereret illustration for AIBI. En fiktiv kontrolseddel viser forskellen ved grænsen 5.
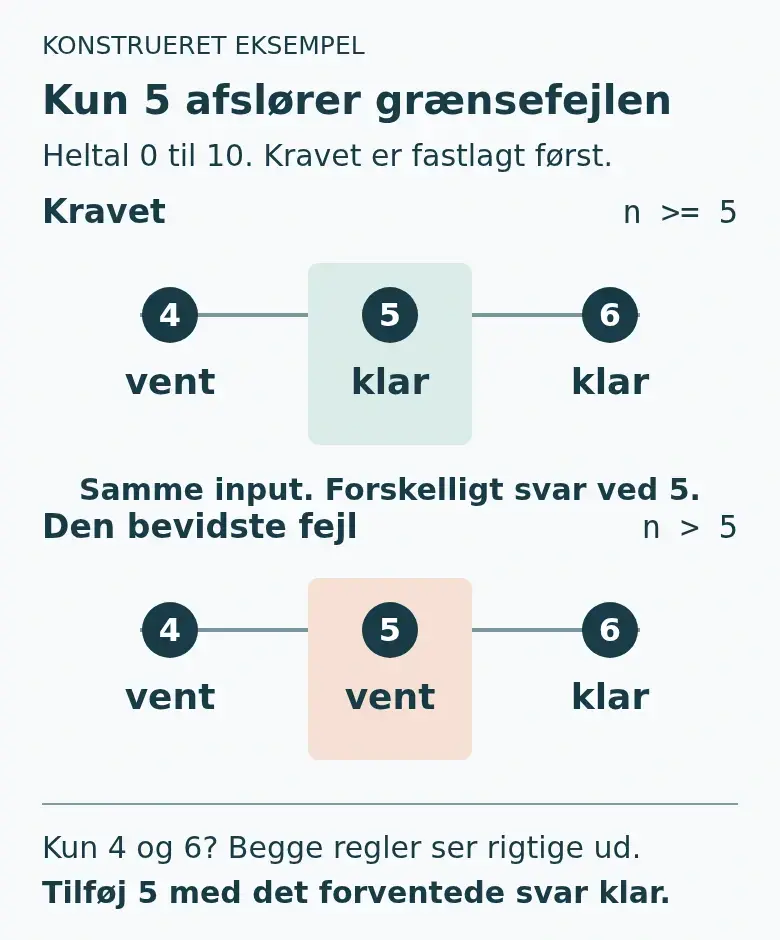
Forestil dig en funktion, der modtager et heltal fra 0 til 10. Kravet er: Den skal returnere "klar" ved 5 eller derover og "vent" under 5. Før vi ser på koden, kan vi derfor skrive tre kendte svar ned:
| Input | Forventet svar | Begrundelse |
|---|---|---|
4 |
"vent" |
Under grænsen |
5 |
"klar" |
Selve grænsen er med |
6 |
"klar" |
Over grænsen |
To grønne assertions kan overse fejlen
Denne mulige test undersøger et tal på hver side af grænsen:
"""Constructed weak test, not output from an AI product."""
import unittest
from threshold import threshold


class ThresholdWeakTest(unittest.TestCase):
    def test_below(self):
        self.assertEqual(threshold(4), "vent")

    def test_above(self):
        self.assertEqual(threshold(6), "klar")


if __name__ == "__main__":
    unittest.main()
En assertion er her sammenligningen mellem funktionens faktiske resultat og det svar, kravet foreskriver. Begge assertions er rigtige, men de skelner ikke mellem >= 5 og > 5. Se på den bevidst forkerte variant:
def wrong(score: int) -> str:
    if not 0 <= score <= 10:
        raise ValueError("score must be in 0..10")
    return "klar" if score > 5 else "vent"
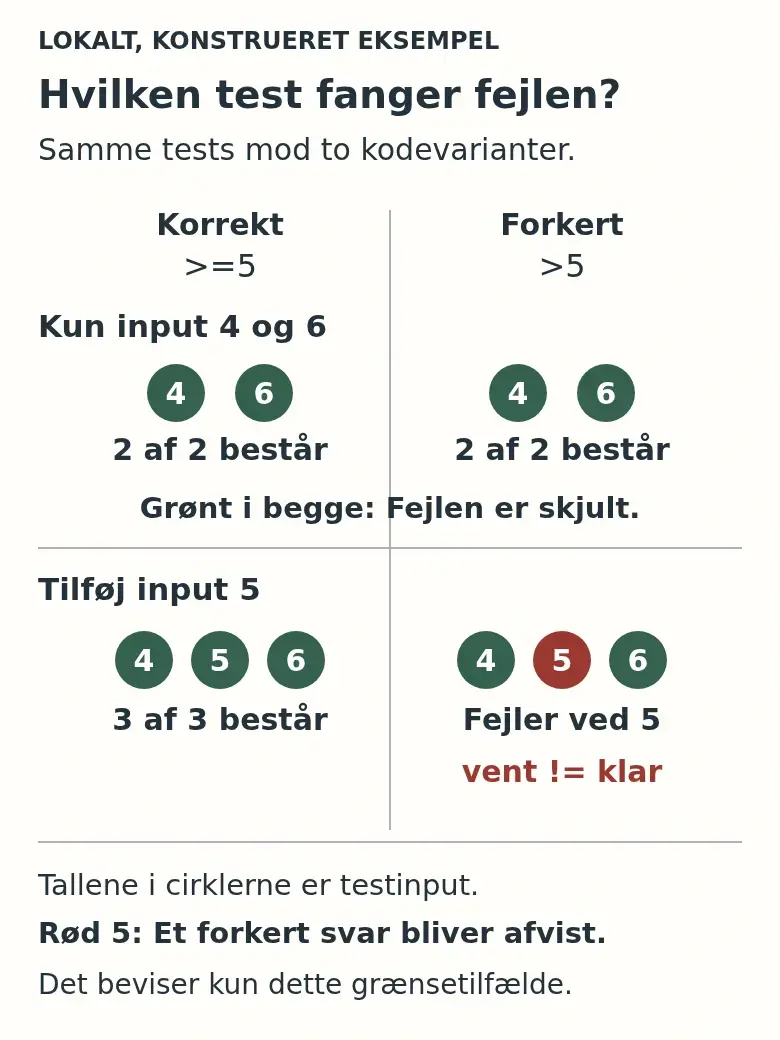
Den returnerer stadig "vent" for 4 og "klar" for 6. Den svage test er derfor grøn, selv om funktionen bryder kravet ved 5. At testen kører gennem en kodegren, viser ikke i sig selv, at dens forventede svar dækker den aftalte adfærd. Hvis du vil vide, om en test opdager denne fejl, skal du lade den møde en implementering, der faktisk har fejlen.
Læg grænsen ind, og se hvad der sker
Du kan gentage kontrollen med tre filer i samme mappe. Gem først dette som threshold.py. Miljøvariablen vælger, hvilken funktion navnet threshold peger på; wrong har med vilje fejlen > 5.
"""Constructed 0..10 threshold example; no customer or production code."""
import os


def correct(score: int) -> str:
    if not 0 <= score <= 10:
        raise ValueError("score must be in 0..10")
    return "klar" if score >= 5 else "vent"


def wrong(score: int) -> str:
    if not 0 <= score <= 10:
        raise ValueError("score must be in 0..10")
    return "klar" if score > 5 else "vent"


threshold = {"correct": correct, "wrong": wrong}[os.environ.get("THRESHOLD_VARIANT", "correct")]
Gem testen med 4 og 6 ovenfor som test_weak.py. Gem derefter denne udvidede version som test_boundary.py. Den ekstra assertion for 5 følger direkte af kravet.
"""Constructed correction with independently specified boundary expectation."""
import unittest
from threshold import threshold


class ThresholdBoundaryTest(unittest.TestCase):
    def test_below(self):
        self.assertEqual(threshold(4), "vent")

    def test_at_boundary(self):
        self.assertEqual(threshold(5), "klar")

    def test_above(self):
        self.assertEqual(threshold(6), "klar")


if __name__ == "__main__":
    unittest.main()
Kør fra mappen med filerne. Prøv først den korte test mod begge varianter og derefter testen med grænsen:
THRESHOLD_VARIANT=correct python3 -m unittest -v test_weak.py
THRESHOLD_VARIANT=wrong python3 -m unittest -v test_weak.py
THRESHOLD_VARIANT=correct python3 -m unittest -v test_boundary.py
THRESHOLD_VARIANT=wrong python3 -m unittest -v test_boundary.py
I denne lokale, konstruerede kørsel bestod begge varianter de to første tests. Den korrekte variant bestod også alle tre tests med grænsen. Den forkerte variant fejlede ved 5: Den gav "vent", mens kravet siger "klar". Det er en assertionfejl om den aftalte adfærd, ikke en importfejl eller et problem med testopsætningen.
GitHubs vejledning om at skrive tests med Copilot viser blandt andet Python-tests og siger, at genererede testtilfælde kan mangle scenarier og skal gennemgås. Deres eksempel på en prompt til unit tests nævner grænseværdier, fejltilfælde og returværdier. Det er nyttige forslag til, hvad du kan efterspørge. Ingen af dem gør en grøn test til bevis for, at alle relevante tilfælde er dækket.
Når du vurderer en test, så hold dens forventede svar op mod kravet, før du kører den. Prøv derefter et input, som ville afsløre en plausibel forkert implementering. I dette eksempel var det 5. Hvis kravet slet ikke angiver, hvad der skal ske på grænsen, kan testen ikke afgøre det for dig; få den beslutning fra den, der ejer kravet, før du fastlåser en assertion.
En AI-kommentar til kode kræver en beslægtet, men anden kontrol. I guiden om at teste en kommentar fra AI-kodegennemgang omsættes kommentaren til en konkret påstand om koden. Her er genstanden selve den foreslåede test: Er dens forventning rigtig, og ville den afvise den fejl, du er bekymret for? Når den gør det for det aftalte grænsetilfælde, kan du beholde eller rette testen med en konkret begrundelse. Kør stadig projektets øvrige relevante tests; dette ene eksempel viser ikke, at hele funktionen er fejlfri.