Træning og inferens: se forskellen i et lille regneeksempel
Følg et lille regneeksempel fra justering af en models parametre til en ny forudsigelse. Se, hvad der ændres under træning.
Træning ændrer modellen. Inferens bruger modellen, som den er. Det kan ses i et lille regneeksempel med to datapunkter.
Vi starter med modellen y'=2x. Den forudsiger 2 og 4, selv om de korrekte værdier i vores to punkter er 3 og 5. Under træningen justerer vi modellens bias fra 0 til 1. Modellen bliver dermed y'=2x+1, og forudsigelserne bliver 3 og 5.
Derefter stopper vi med at justere modellen. Når vi bruger den færdige formel på et nyt input, x=3, får vi outputtet 7. Det trin er inferens.
Først måler vi modellens fejl
En enkel lineær model kan skrives som:
y'=wx+b
Her er x inputtet, y' modellens forudsigelse, w vægten og b bias. Vægt og bias er modellens parametre. Det er tal, som kan justeres under træningen.
I vores tænkte eksempel har vi to datapunkter:
x=1, y=3x=2, y=5
Vi begynder med vægten 2 og bias 0. Formlen er derfor y'=2x.
For det første punkt bliver forudsigelsen:
2 gange 1 = 2
For det andet punkt bliver den:
2 gange 2 = 4
Begge forudsigelser ligger 1 fra den korrekte værdi. Vi måler fejlen med middelkvadratfejl, ofte forkortet MSE. Hver forskel opløftes i anden, og resultaterne lægges sammen og divideres med antallet af punkter:
MSE = ((2-3)^2 + (4-5)^2) / 2 = (1+1) / 2 = 1
MSE er altså 1 for de to punkter med den første model.
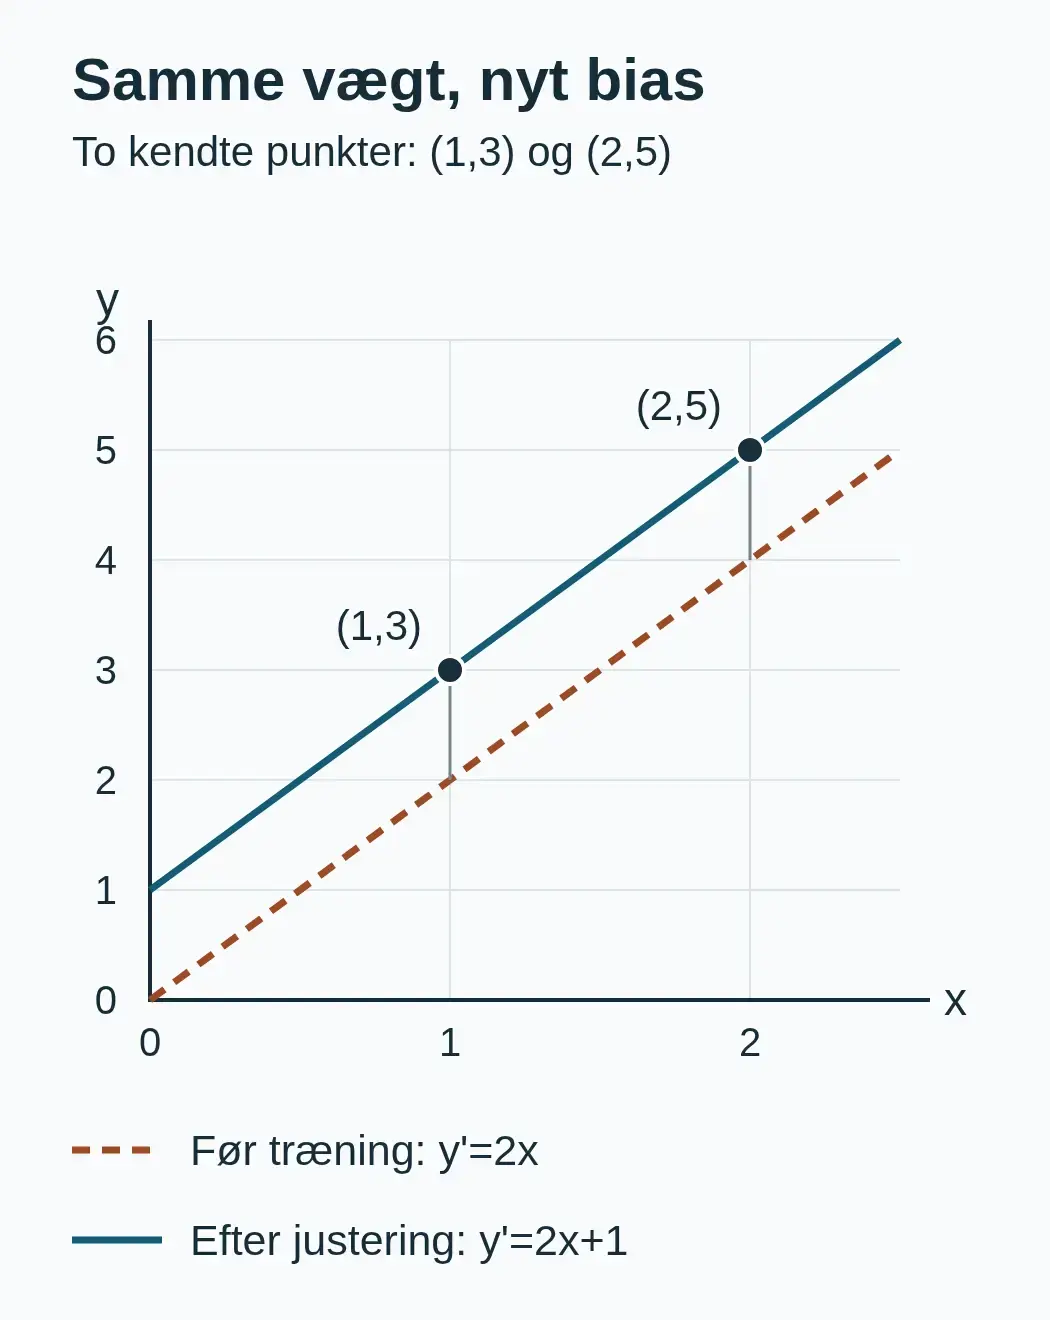
Under træning ændrer vi en parameter
Nu udfører vi eksemplets træningstrin. Vi beholder vægten 2, men ændrer bias fra 0 til 1. Den nye formel er:
y'=2x+1
De nye forudsigelser bliver:
- Når
x=1:2 gange 1 + 1 = 3 - Når
x=2:2 gange 2 + 1 = 5
Den nye middelkvadratfejl er:
MSE = ((3-3)^2 + (5-5)^2) / 2 = (0+0) / 2 = 0
Det afgørende er ikke blot, at fejlen faldt. Det afgørende er, at en modelparameter blev ændret. I virkelige træningsforløb søger en optimeringsmetode typisk efter parametre, der reducerer en tabsfunktion. Her vælger vi ændringen direkte for at gøre forskellen synlig. Det er et konstrueret regneeksempel, ikke en udført optimeringstest.
Under inferens holder vi parametrene fast
Efter træningstrinnet fastlåser vi vægten til 2 og bias til 1. Nu giver vi modellen et nyt input:
x=3
Modellen beregner:
y'=2 gange 3 + 1 = 7
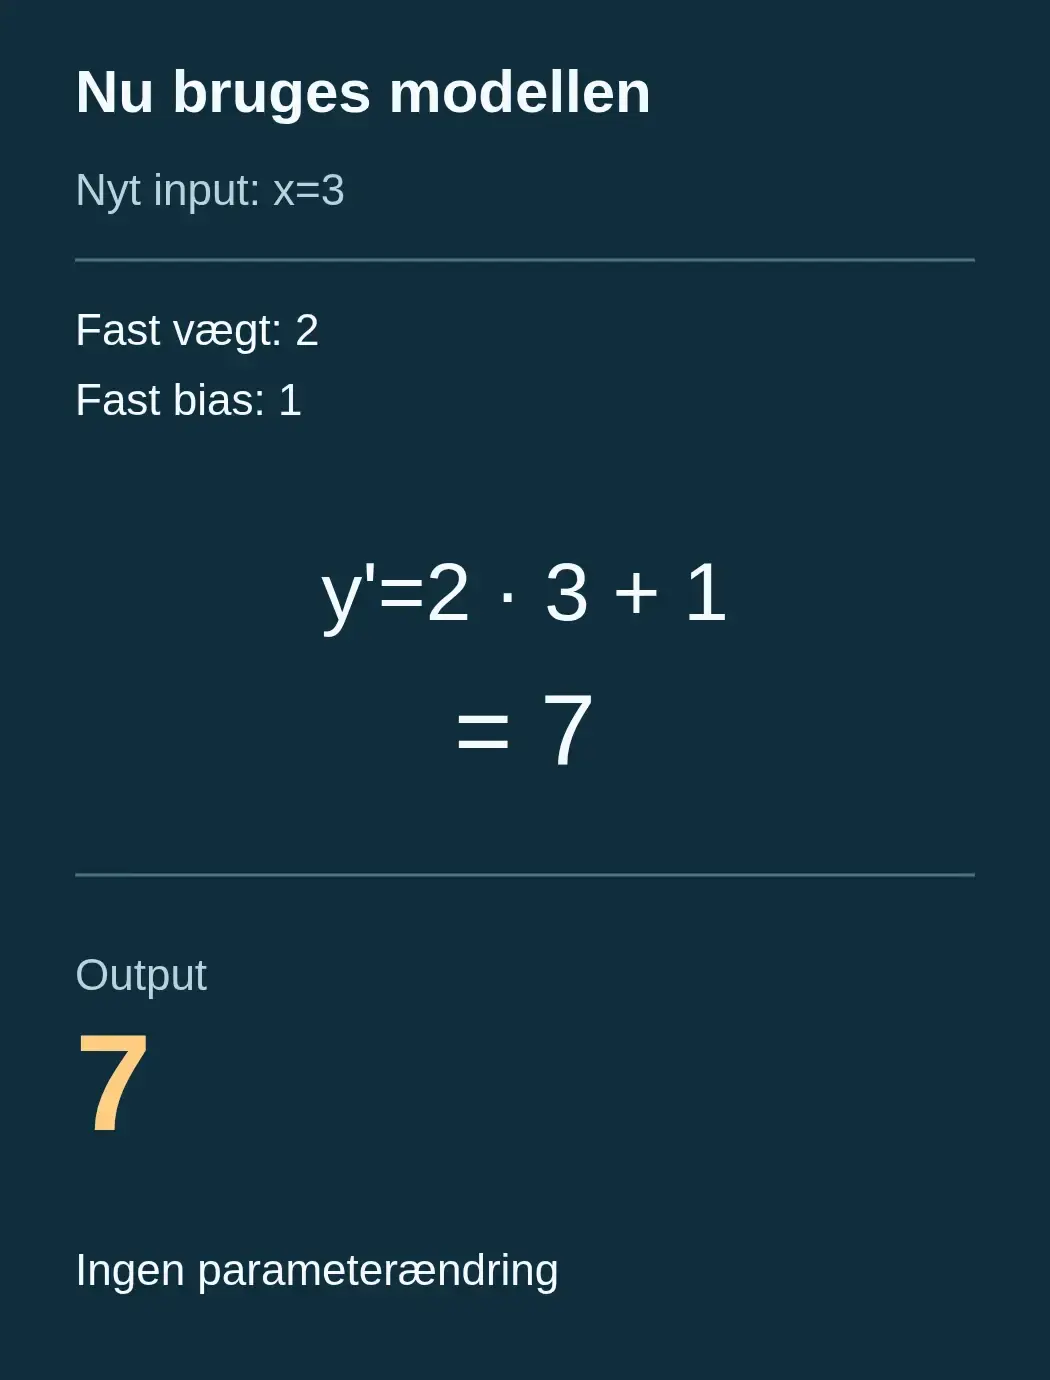
Outputtet er 7. Hverken vægten eller bias ændres i dette trin. Modellen bruger blot sine faste parametre til at lave en forudsigelse. Det er inferens i eksemplet.
Et system kan godt få nye oplysninger som en del af inputtet uden at blive trænet på ny. I et RAG-system kan hentede dokumentuddrag for eksempel gives til modellen som kontekst. Det er ikke i sig selv det samme som at ændre modellens parametre.
Hvad resultatet viser, og ikke viser
Forskellen kan nu siges helt kort:
- Under træning ændrede vi bias fra
0til1for at reducere fejlen på de to datapunkter. - Under inferens beholdt vi vægten
2og bias1og beregnede et output forx=3.
At MSE blev 0 på to konstruerede punkter betyder ikke, at modellen er præcis i den virkelige verden. Det viser kun, at den valgte linje rammer netop disse to punkter. Eksemplet siger heller ikke, at alle AI-systemer altid holder parametrene uændrede under brug. Det viser præcist, hvad der sker i denne afgrænsede beregning: Først ændrer vi en parameter, derefter bruger vi de faste parametre til en ny forudsigelse.